·읽는 데 2분Event
RL·Post-training 밋업 ‘Benchmark Social 0.1’을 열었습니다
9월 9일 NAVER D2SF 강남에서 Team Attention과 함께 연 밋업의 후기와 발표 자료입니다.
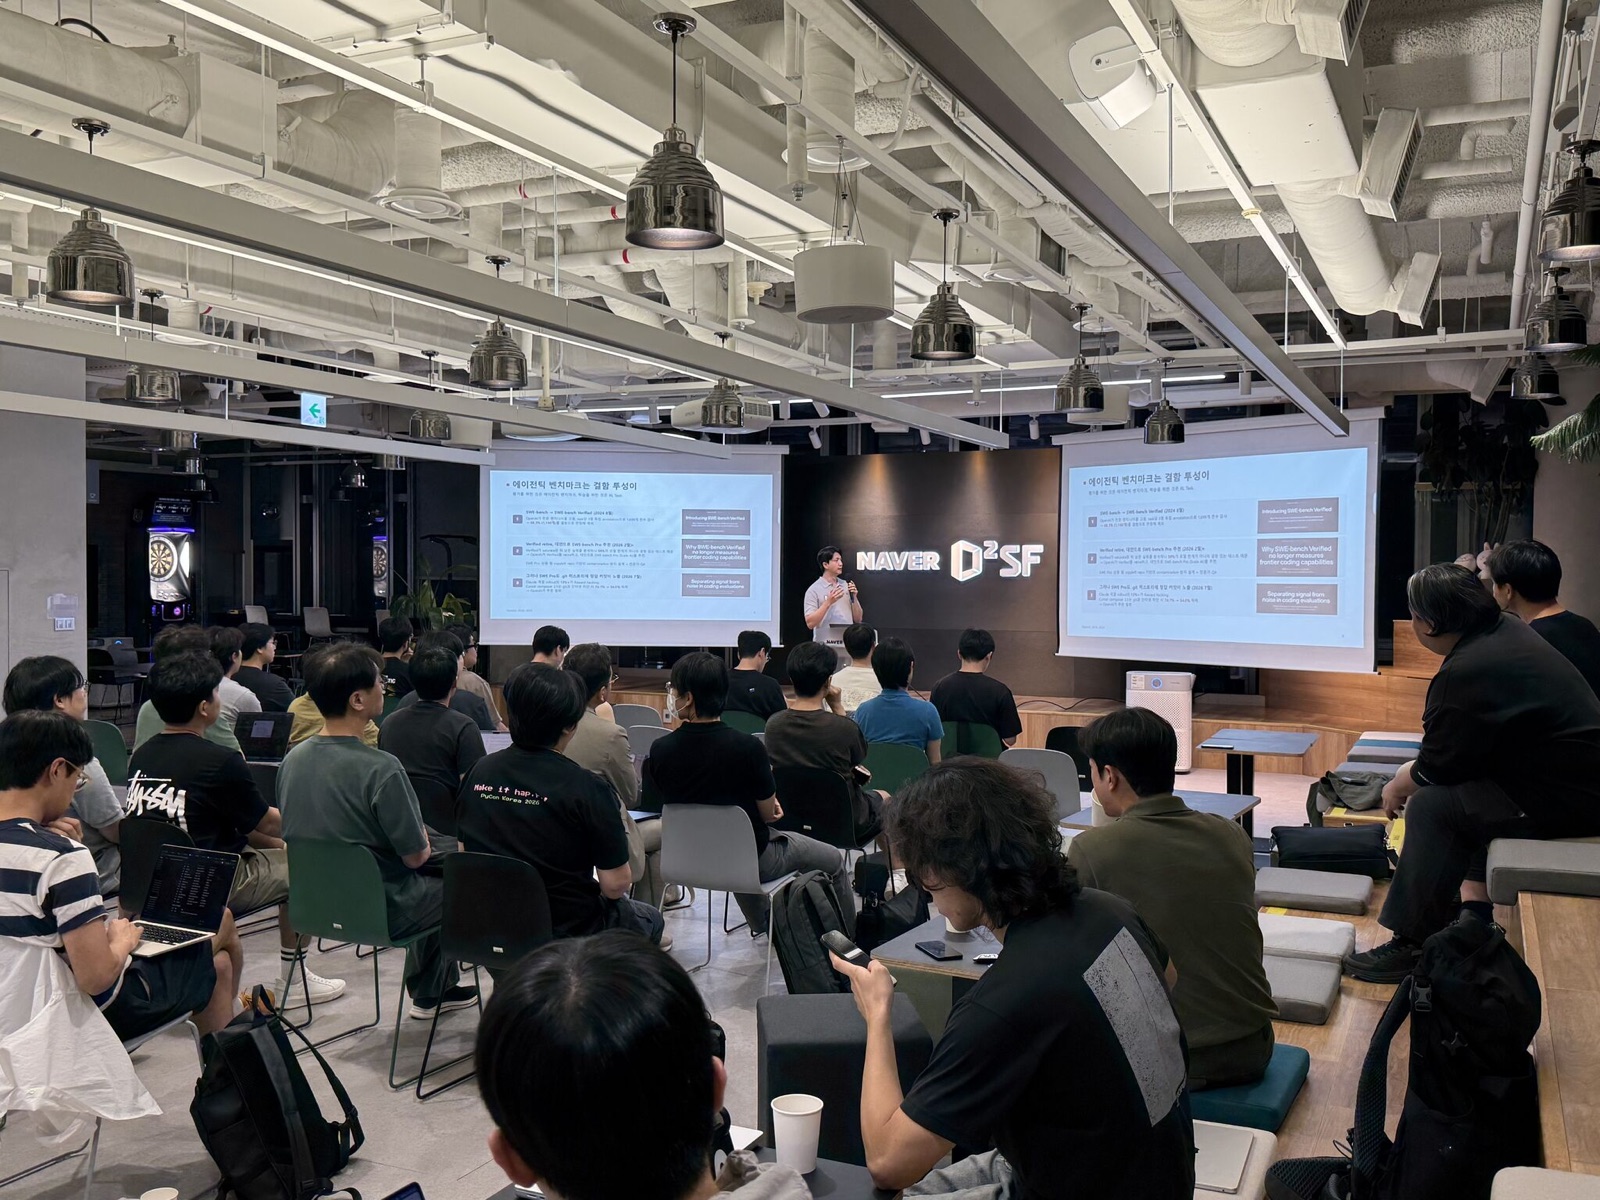
9월 9일 저녁, Team Attention과 함께 NAVER D2SF 강남에서 RL과 post-training을 주제로 한 밋업 Benchmark Social 0.1을 열었습니다. 국내에서 RL과 post-training을 하는 분들이 모여, 각자 해 본 실험과 시행착오를 편하게 나누는 자리였습니다.
Delphik은 「Post-training의 시대: RL 데이터를 어떻게 개선할 것인가」라는 주제로 발표했습니다. 내용은 크게 세 가지입니다.
- 배경. Pre-training에서는 모델이 인터넷에 있는 글을 읽고 배웠습니다. Post-training에서는 전문가가 만든 문제, 즉 task를 직접 풀면서 배웁니다. Task 하나는 프롬프트, 실행 환경, 그리고 채점을 맡는 verifier로 이루어집니다.
- 문제. 공개된 에이전틱 벤치마크를 뜯어보면 결함이 끊임없이 나옵니다. OpenAI가 SWE-bench Verified를 만들 때 사람이 직접 검토한 1,699개 중 68.3%가 걸러졌을 정도입니다. Verifier가 프롬프트와 다른 것을 채점하거나 지름길로 가도 통과시켜 주면, 모델은 문제를 푸는 대신 verifier를 통과하는 요령을 배웁니다. 그래서 데이터 품질 문제이면서 안전 문제이기도 합니다. 원인은 RL task의 구조에 있습니다. 정적인 데이터는 항목을 하나씩 검수하면 되지만, RL task는 에이전트가 갈 수 있는 모든 경로와 경로마다 받는 보상까지 검수해야 합니다. 검수를 LLM에 맡기는 것만으로는 아직 부족합니다. 우리가 만든 Task Verification Bench에서 모델이 결함의 실제 원인까지 맞힌 비율은 35~60%였습니다.
- 해법. 그래서 AI 랩은 납품받은 task를 그대로 믿지 말고 인수 검사(acceptance test)를 해야 합니다. 발표 마지막에는 Delphik이 이 검사를 어떻게 하는지 소개했습니다. 벤더가 골라서 보내 주는 샘플이 아니라 전체 데이터셋에서 무작위로 뽑은 샘플을 실제로 돌려 보고, 품질과 난이도를 측정합니다.
와 주신 모든 분께, 그리고 함께 준비해 주신 Team Attention과 장소를 내어 주신 NAVER D2SF에 감사드립니다.