결함 신고가 하나도 없는 벤치마크는 깨끗한 게 아닙니다. 아무도 검증해 보지 않은 겁니다.
벤치마크의 건강 상태는 결함 개수가 아니라, 발견된 결함이 수정까지 이어지느냐로 봐야 합니다. 결함 스레드 1,874개를 따라가며 발견(found), 수정 중(fixing), 수정 완료(fixed) 단계에 각각 얼마나 있는지, 그리고 얼마나 아직 열려 있는지 살펴봤습니다.
벤치마크 품질을 가늠할 때 빠지기 쉬운 함정이 있습니다. 이슈 트래커가 텅 빈 repo는 건강해 보이고, 열려 있는 결함 스레드가 100개씩 쌓인 repo는 망가진 것처럼 보입니다. 실제로는 대개 반대입니다. 조용한 벤치마크는 아무도 제대로 돌려 보지 않은 벤치마크이고, 시끄러운 벤치마크는 문제가 드러날 만큼 사람들이 많이 돌려 본 벤치마크입니다.
그래서 “결함이 몇 개 신고됐나”는 건강 상태를 재는 지표로 맞지 않습니다. 더 나은 지표는 흐름입니다. 결함이 얼마나 발견되고, 그중 얼마나 수정 단계로 넘어가고, 얼마나 실제로 반영되고, 얼마나 아직 열려 있는지를 봐야 합니다. 건강한 벤치마크란 불만이 없는 벤치마크가 아니라, 발견된 결함이 수정으로 이어지는 벤치마크입니다.
결함을 찾아내는 사람들은 바로 앞 글에서 다뤘습니다. 에이전틱 벤치마크 repo 62개의 public auditor 744명입니다. 이 글은 그다음 이야기입니다. 누가 신고하느냐가 아니라 신고된 다음에 무슨 일이 일어나는지를 봅니다. 같은 결함 스레드 1,874개(전부 다시 읽어 확인한 진짜 결함은 1,616개)를 대상으로 이 흐름을 추적했습니다. 벤치마크의 health 페이지가 실제로 무엇을 보여 줘야 하는지 미리 보여 드리려는 것입니다.
벤치마크부터 보겠습니다. 결함 스레드가 많은 순서로 줄을 세워 보면, 이 목록은 “버그가 가장 많은 eval”이 아니라 “가장 많이 검증받은 eval” 목록에 가깝습니다. 색은 각 결함이 흐름의 어느 단계에 있는지를 나타냅니다. 얼마나 해결됐는지가 벤치마크마다 크게 다르다는 것이 이 그림에서 이미 드러납니다.
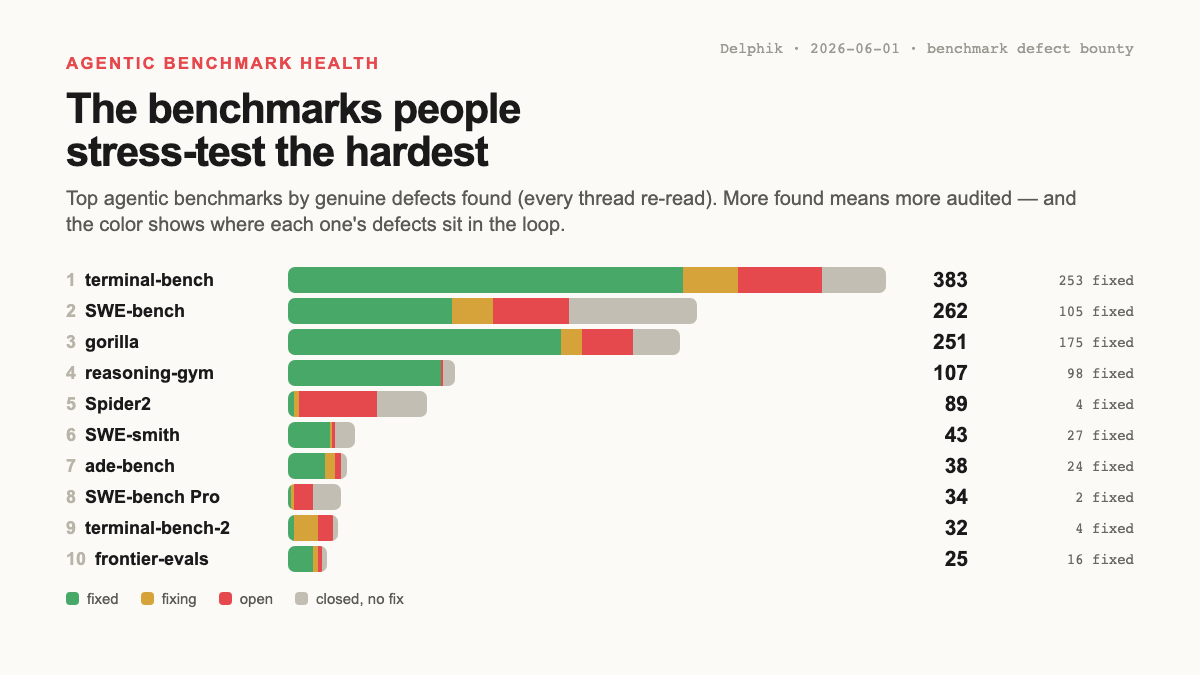
같은 종류의 결함인데도 해결 정도는 repo마다 크게 다릅니다. reasoning-gym은 신고된 결함의 약 90%가 머지된 PR로 고쳐졌지만, Spider2는 “정답 쿼리나 정답이 틀렸다”는 신고 약 50건이 아직 열린 채 쌓여 있습니다. 열려 있는 신고가 많다는 것은 신고된 결함이 실제로 고쳐지지 않고 있다는 뜻입니다. repo를 PR 중심으로 운영하든, Issue 중심으로 운영하든, commit으로 바로 고치든 마찬가지입니다. (Spider2의 열린 신고들이 PR 연결만 빠진 것이 아니라 정말로 고쳐지지 않았는지는 commit을 전부 읽어 확인했습니다.) Health 페이지는 바로 이럴 때 필요합니다. 사용자가 지금 돌리려는 버전에서 알려진 결함이 실제로 얼마나 정리됐는지 알려 주기 때문입니다.
Found, fixing, fixed
개별 repo에서 한 걸음 물러나 진짜 결함 1,616개 전체를 보면, 대부분은 이 흐름을 따라 움직였습니다.
- open 315개. Issue는 올라왔지만 아직 수정이 시작되지 않았습니다.
- fixing 132개. 열려 있는 PR, 즉 리뷰 중인 수정 제안입니다.
- fixed 817개. 근거가 되는 머지된 PR이 있습니다(머지된 수정 PR이거나, 그런 PR로 닫힌 Issue).
- closed 352개. 머지된 PR 없이 닫혔고, 이 흐름 바깥에 있습니다.
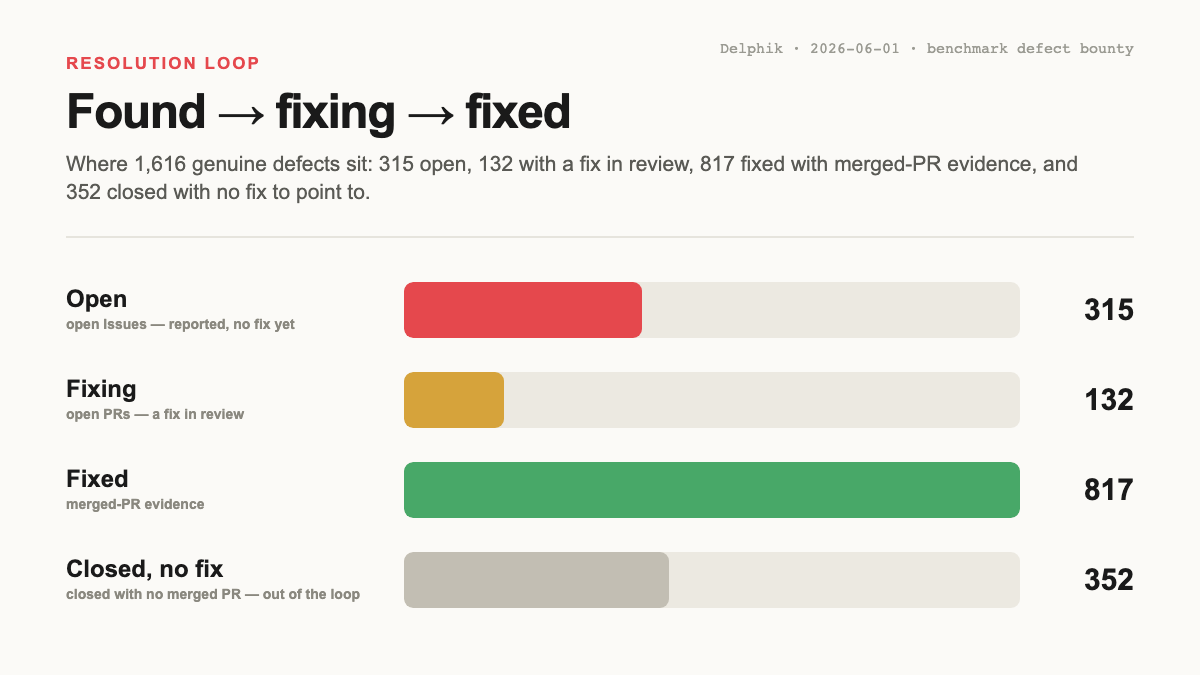
앞의 세 가지가 흐름입니다. found → fixing → fixed. 가장 눈여겨볼 것은 큰 초록색 막대입니다. 신고된 결함의 대부분은 결국 고쳐집니다.
네 번째 묶음만큼은 일부러 보수적으로 셌습니다. 머지된 PR 없이 닫힌 352개는 고쳐졌다고 볼 근거가 없습니다. 그렇다고 전부 의미 없는 신고인 것도 아닙니다. 고치지 않기로 한 것(won’t-fix), 중복 신고, 연결되지 않은 commit으로 이미 고쳐진 것, 그리고 가끔은 끝내 결함으로 인정되지 않은 신고가 섞여 있습니다. “closed”가 곧 “fixed”는 아닙니다. 그래서 health 지표는 GitHub의 열림/닫힘 상태가 아니라 머지 근거를 따라가야 합니다.
수정은 출시 직후에만 몰리지 않고 계속됩니다
결함은 출시 직후에 몰렸다가 점점 줄어들 거라고 생각하기 쉽습니다. 몰리는 것은 맞지만, 줄어들지는 않습니다.
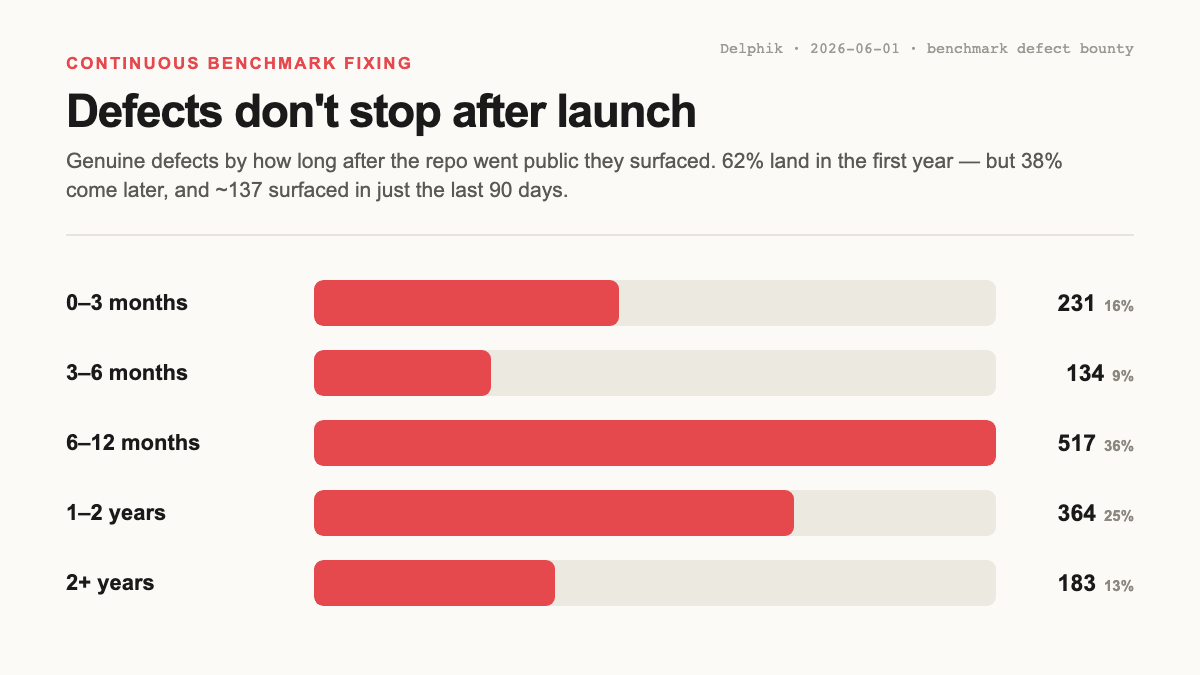
882개(62%)는 첫 1년 안에 나왔지만 547개(38%)는 1년이 지난 뒤에 나왔고, 최근 90일 동안에만 약 137개가 나왔습니다. 벤치마크는 출시되고 한참 뒤에도 계속 결함이 나옵니다. 더 강한 에이전트가 새로운 방식으로 계속 파고들기도 하고, 벤치마크가 딛고 있는 환경이 달라지기도 하기 때문입니다. Base image가 업데이트되고, 고정해 둔 의존성 버전이 낡고, 외부 API가 바뀌면서 예전에는 재현되던 task가 더는 재현되지 않습니다. 벤치마크를 건강하게 유지하는 일에는 끝이 없습니다. 그래서 아무리 잘한 감사라도 한 번으로 끝낼 수 없습니다. BenchJack(Wang et al., 2026)은 exploit 관점에서 비슷한 현상을 실험으로 확인했습니다. 벤치마크의 허점을 한 차례 막는 것으로는 부족한 경우가 많았습니다. 다시 감사하면 hack 성공률이 도로 올라갔고, 몇몇 벤치마크는 완전히 막기까지 여러 차례 반복해야 했습니다(§5.3, Fig. 7).
정적 벤치마크에도 버그는 있습니다. 다만 결함이 생길 수 있는 범위가 다릅니다
정적(static) 벤치마크도 깨끗하지 않습니다. 잘 알려진 정적 벤치마크 10개의 Issue와 PR을 전부 다시 읽어 보니 10개 모두에서 진짜 결함이 나왔습니다. 틀린 정답, 중복 라벨, 모호한 질문, 채점 버그 같은 것들입니다. 다만 task 수에 비하면 훨씬 드뭅니다. 각 부류에서 GitHub star 상위 10개를 고르고(결함 수가 아니라 인기 기준입니다) 벤치마크별 결함 스레드 수를 실제 task 수로 나눠 보면, 에이전틱 벤치마크는 평균 task 1,000개당 약 266건, 정적 벤치마크는 57건입니다. 다시 검증한 진짜 결함 기준으로 약 4.6배입니다(벤치마크 중앙값 기준으로는 약 7배).
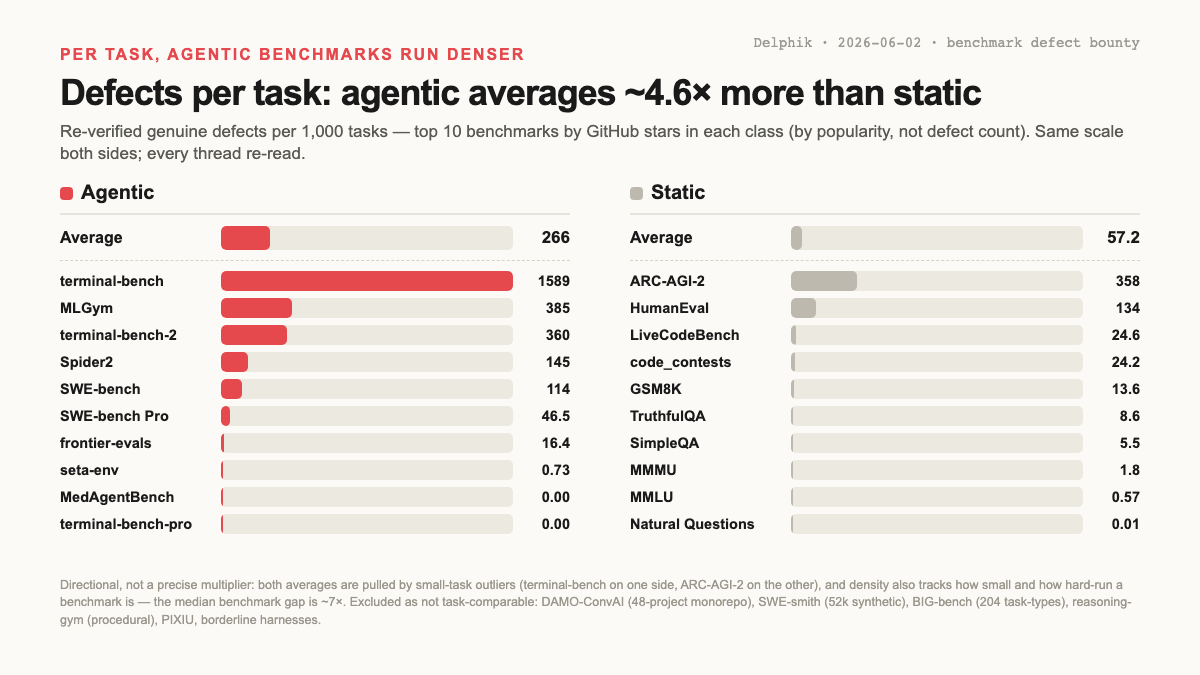
이 배수는 정확한 값이라기보다 대략적인 경향을 보여 주는 값입니다. 두 평균 모두, 규모가 작고 실행 횟수가 많은 이상치 하나에 크게 좌우됩니다. 에이전틱 쪽은 terminal-bench, 정적 쪽은 ARC-AGI-2입니다. 결함 밀도는 벤치마크에 버그가 얼마나 많은지 못지않게 벤치마크가 얼마나 작고 얼마나 많이 실행되는지에도 좌우됩니다. 작은 정적 코드·추론 벤치마크 몇 개의 밀도가 꽤 높게 나오는 것도 그래서입니다. “정적 벤치마크는 괜찮다”는 말이 아닙니다. 에이전틱 벤치마크에는 결함이 생길 수 있는 곳이 더 많다는 말입니다. Task 설정, 도구와 API, 환경, harness, verifier/oracle 로직, 그리고 trajectory 자체까지 있고, 어디서 생기든 전부 점수에 반영됩니다. 그래서 벤치마크 health는 정오표 한 장이 아니라 수집 → 분류 → 수정 → 수정된 버전 배포로 이어지는 흐름이어야 합니다.
Defect Hub의 역할
이 글에서 다룬 내용은 전부 GitHub Issue와 PR에 있던 것입니다. 논의와 패치는 거기 있는 것이 맞고, 앞으로도 그래야 합니다. 하지만 GitHub는 대화와 머지는 담아도 벤치마크는 담지 못합니다. 모델 weight가 일반 Git repo가 아니라 Hugging Face로 간 것과 같은 이치입니다. Git은 코드에는 잘 맞지만, 코드를 둘러싼 산출물에는 맞지 않습니다. 벤치마크 결함이 바로 그런 산출물입니다. 결함에는 task, 버전, 실행 trajectory, 그리고 점수에 미치는 영향이 딸려 있는데, Issue에는 이 중 어느 것도 담을 수 없습니다. 그래서 세 가지가 빠지게 되고, Defect Hub는 그 세 가지를 채우려고 만들었습니다.
첫째, 결함 하나를 스레드 하나로 묶어 관리합니다. 열린 Issue가 쌓이기만 하는 것과는 다릅니다. 지금은 근거가 흩어져 있습니다. Spider2의 열린 “정답 오류” 신고 약 50건 중에는 같은 결함이 두 번 이상 올라온 것도 있고, 어느 것도 실행 기록이나 문제가 되는 버전과 연결돼 있지 않습니다. 반대의 경우도 있습니다. 결함을 commit으로 바로 고쳤는데 Issue를 닫지 않아 여전히 열려 있는 것처럼 보이는 경우입니다. 어느 쪽이든 GitHub의 열림/닫힘 상태가 실제 상태를 말해 주지는 않습니다. Defect Hub는 결함을 하나의 단위로 다룹니다. 코딩 에이전트 안에서 /report-defect 한 줄로 실행 trajectory와 함께 기록하고, 중복을 걸러 메인테이너에게 전달한 뒤, 실제 수정과 수정 버전 재배포까지 추적합니다. 아무도 닫지 않는 백로그가 아니라 found → fixing → fixed로 이어지는 흐름입니다. 지난주에 공개했습니다.
둘째, 메인테이너가 자신 있게 내보일 수 있는 공개 health 기록입니다. 벤치마크별로 found → fixing → fixed 흐름을 보여 줍니다. 벤치마크가 꾸준히 관리되고 있다는 것을 사용자에게 주장이 아니라 근거로 보여 줄 수 있습니다. 이번 주에 공개됩니다.
셋째, 벤치마크가 고쳐지면 함께 움직이는 리더보드입니다. 결함을 고치면 점수가 바뀝니다. Terminal-Bench는 task 89개 중 28개를 고쳤고, 그 결과 순위는 대체로 그대로인 채 최상위 에이전트의 점수가 약 12점 올랐습니다(관련 글). 버그가 있던 버전에서 한 번 측정하고 그대로 둔 프론티어 모델 점수는 이런 변화를 반영하지 못합니다. 다만 수정으로 바뀌는 task는 몇 개뿐입니다. 그러니 벤치마크 전체를 다시 돌릴 필요 없이, 고쳐진 task만 모델별로 다시 채점하면 됩니다. 그래야 점수가 버그가 있던 버전에 묶이지 않고 현재 버전을 따라갑니다. 다음 주에 공개됩니다.
한 가지 솔직하게 밝혀 둘 한계가 있습니다. 결함 개수 그대로는 health 점수가 아닙니다. 제대로 된 지표라면 task 수와 사용량(star, clone, 실행 횟수)으로 정규화해야 합니다. 감사받지 않은 벤치마크는 아직 아무도 결함을 찾아보지 않아서 깨끗해 보일 뿐이기 때문입니다. 이 정규화는 다음 과제이고, 오늘 이 글에서 주장하는 내용은 아닙니다. 이 벤치마크들이 버티고 있는 것은 이미 이 일을 하고 있는 744명 덕분입니다. 우리가 할 일은 다음 신고가 지난번 신고보다 덜 힘들게 만드는 것입니다. 깨진 eval task를 만났을 때, 신고는 명령어 한 줄이면 되어야 합니다.
방법과 한계
2026-06-01 기준으로 에이전틱 벤치마크 repo 62개의 GitHub Issue/PR 스레드 6,245개를 스냅샷으로 떴습니다. 그중 1,874개를 결함으로 보이는 스레드로 표시했고, 전부 다시 읽은 결과 1,616개가 진짜 결함이었습니다(아래 재검토 설명 참고). 이 결함들을 어떻게 찾고 분류했는지, 즉 스레드를 어떻게 읽고(키워드 매칭이 아니라 코딩 에이전트가 직접 읽었습니다) 점수를 매기고 public auditor와 repo 팀으로 나눴는지는 앞 글에 정리해 두었습니다. 이 글은 분류 이후를 다루며, 진짜 결함 1,616개를 흐름상의 위치에 따라 다음과 같이 나눕니다.
- fixed (817). 근거가 되는 머지된 PR이 있는 경우입니다. 머지된 PR이거나, 연결된 PR이 머지되면서 닫힌 Issue입니다.
- fixing (132). 열려 있는 PR, 즉 리뷰 중인 수정 제안입니다.
- open (315). 아직 머지된 결과가 없는 열린 Issue입니다.
- closed (352). 머지된 PR 없이 닫힌 경우입니다.
“open” 수치는 따로 검증했습니다. 연결된 PR 없이 commit으로 바로 결함을 고치는 repo도 있어서, 머지된 PR만 근거로 삼지 않았습니다. 36개 repo의 commit 7,722개를 (subagent로) 전부 읽고, 아직 열려 있는 결함마다 실제로 그것을 고친 commit이 있는지 확인했습니다. 키워드 매칭이 아니라 diff를 읽어서 확인했습니다. 이렇게 조용히 고쳐진 결함은 약 5%뿐이었습니다. 따라서 여기 나온 open 수치는 commit으로 고치는 관행 때문에 부풀려진 것이 아니라 실제 값입니다.
그 밖에 알아 둘 점은 다음과 같습니다.
- 이 글의 수치는 모두 진짜 결함 기준입니다(독립 재검토). 한 메인테이너가 집계 기준이 모호하다고 지적한 뒤, 표시해 둔 스레드 1,874개를 전부 다시 읽었습니다. 제목만이 아니라 본문과 diff까지, 에이전틱과 정적 양쪽 모두 읽었고, 다른 모델에게 독립적으로 다시 분류시켰습니다. 그 결과 1,616개가 진짜 벤치마크 결함입니다(약 86%. 경계에 있는 사례를 얼마나 엄격하게 세느냐에 따라 엄격 기준 80%에서 포괄 기준 96% 사이입니다). 나머지는 1차 분류기가 결함으로 잘못 넣은 repo 구축 작업(언어 포팅, CI, 테스트 기본 틀)으로, 오래된 repo 몇 곳에 몰려 있었습니다(예를 들어 QuixBugs는 42개 중 14개였고, QuixBugs와 그 밖의 정적 repo는 제외했습니다). 이 글의 수치는 모두 진짜 결함 수입니다. task당 격차는 어느 기준으로 세든 거의 달라지지 않습니다. 진짜 결함 기준 약 4.6배, 표시된 스레드 기준 약 4.8배입니다. 과다 집계가 양쪽에서 거의 같은 비율로 일어났기 때문입니다.
- 전수 조사가 아니라 표본입니다. 이 글의 수치는 모두 우리가 실제로 감사한 벤치마크에서 나왔습니다. Harbor 인덱스에 있는 에이전틱 벤치마크 기본 세트와, 따로 직접 고른 잘 알려진 정적 벤치마크들입니다. 세상의 모든 벤치마크가 아닙니다. 따라서 “star 상위 10개”는 그 범위 안에서 star가 가장 많은 10개를 뜻합니다. 아직 인덱싱하지 않은 더 유명한 벤치마크는 범위 밖에 있고, 포함되면 리더보드와 개수, 평균이 달라질 수 있습니다. 여기 나온 숫자는 모두 “우리가 다루는 벤치마크를 측정한 값”으로 읽어 주세요. 범위는 계속 넓히고 있습니다.
- 집계 단위는 개별 댓글이 아니라 Issue나 PR 하나에 달린 스레드 전체입니다.
- “fixing”은 열려 있는 PR 수로 근사했습니다. 스레드 단위로 세기 때문에, 신고된 Issue 하나와 그 Issue를 고치는 진행 중인 PR 하나는 open 1건과 fixing 1건으로 따로 잡힙니다. Issue와 열린 PR을 믿을 만하게 연결할 방법이 없어 합치지 않았습니다.
- task 수로 정규화한 비교. 각 부류에서 GitHub star 상위 10개를 골랐습니다. 결함 수가 아니라 인기를 기준으로 삼아, 측정하려는 값 자체를 기준으로 표본을 고르는 일을 피했습니다. 벤치마크별 task 수는 repo와 논문을 직접 읽고 셌습니다(채점되는 항목 하나를 task 하나로 봤습니다). 약 4.6배는 대략적인 경향을 보여 주는 값입니다. 두 평균 모두 task 수가 적은 이상치 하나씩(terminal-bench, ARC-AGI-2)에 좌우되지만, 어느 쪽을 빼더라도 방향은 같고 격차는 여전히 몇 배입니다. task 단위로 비교하기 어려워 task당 차트에서 제외한 것은 다음과 같습니다. 48개 프로젝트가 든 monorepo(DAMO-ConvAI), 52k 규모의 합성 세트(SWE-smith), 절차적 생성기(reasoning-gym), BIG-bench(task 유형 204개), 그리고 경계에 있는 single-shot 실행형 harness 몇 개입니다.
- 출시 시점은 GitHub repo의
created_at을 기준으로 했습니다. 논문 공개일이나 공식 출시일과 다를 수 있으니, 시간축은 “repo가 공개된 이후의 활동”으로 읽어 주세요. - 이 시리즈의 다른 글에서 인용한 외부 수치(SWE-bench Verified 재감사, DeepSWE/SWE-bench Pro 확인)는 우리 데이터가 아니라 해당 팀이 공개한 보고서에서 가져온 것입니다.