에이전틱 벤치마크를 고치고 있는 숨은 공헌자들
벤치마크 repo 62개의 GitHub 스레드 6,245개를 읽고, 이 벤치마크들이 계속 돌아가도록 조용히 손보고 있는 744명을 찾았습니다. 이분들께 드리는 감사 인사이자, 그 바탕이 된 데이터입니다.
코딩 벤치마크의 문제점에 대해서는 이미 꽤 많이 썼습니다. 올바른 코드를 떨어뜨리는 verifier, 유출된 정답, 어떤 에이전트도 풀 수 없는 task 같은 것들입니다. 이런 결함을 찾아내는 일을 모델이 대신해 줄 수 있는지도 다뤘습니다. (짧게 말하면, 분류에는 도움이 되지만 사람을 대신하지는 못합니다. 다른 글에 정리해 두었습니다.)
이 글은 우리끼리 이야기는 자주 했지만 한 번도 제대로 수치로 확인해 본 적 없는 질문을 다룹니다. 이 벤치마크들이 계속 돌아가게 하는 사람은 누구이고, 그 일에는 왜 이렇게까지 품이 많이 들까요?
누군가 하고 있는 것은 분명합니다. 좋은 벤치마크는 꾸준히 관리됩니다. SWE-bench와 Terminal-Bench는 결함이 드러나는 대로 수정해서 배포합니다. 그런데도 결함은 계속 나오니, 유지보수는 사실상 끝나지 않습니다. 이 일은 실제로 품이 드는 노동이고, 대부분 GitHub에서 공개적으로 이루어지며, 그중 상당 부분은 논문에 이름이 실린 사람들이 하는 일이 아닙니다. 그래서 짐작만 하지 않고 직접 세어 봤습니다.
에이전틱 벤치마크 repo 62개에서 GitHub Issue/PR 스레드 6,245개를 읽고, 그중 1,874개를 벤치마크 결함 또는 결함으로 추정되는 스레드로 분류했습니다. 그리고 그 스레드들을 올린 사람 가운데 public auditor 744명을 찾았습니다. 어느 메인테이너 명단에도 없지만 Issue를 열거나, 수정 PR을 올리거나, 둘 다 한 사람들입니다.
이 글은 그분들께 드리는 감사 인사입니다.
결함은 대부분 repo 바깥 사람들이 찾아냅니다
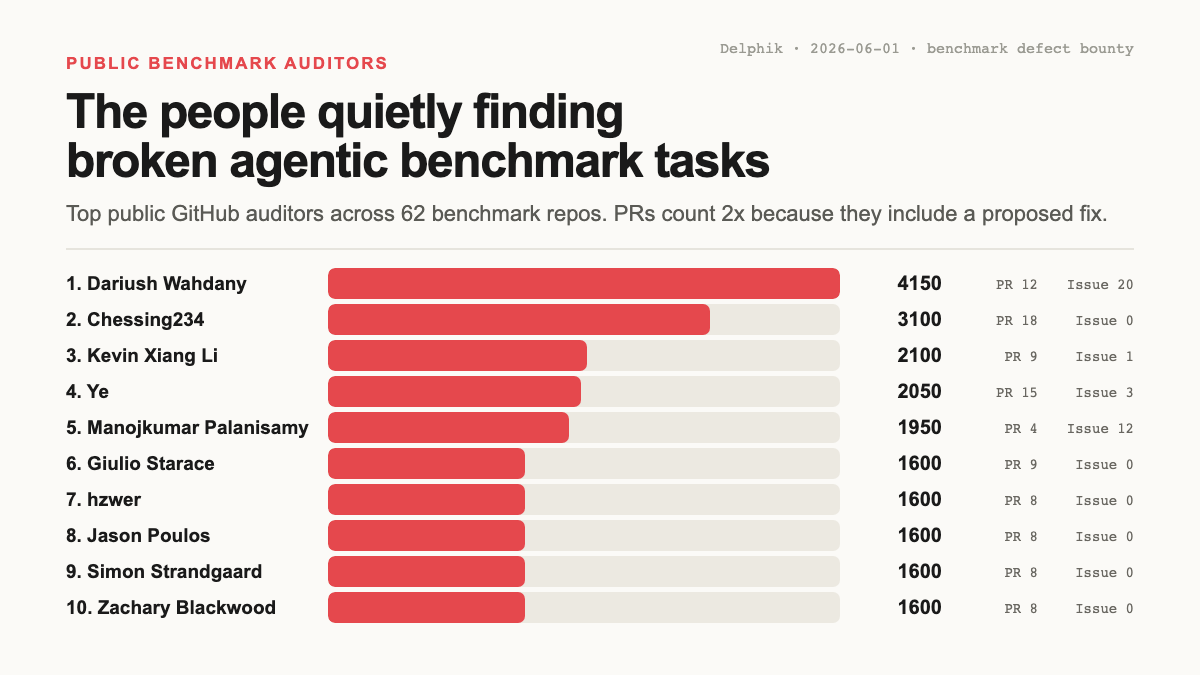
GitHub의 author association이 OWNER, MEMBER, COLLABORATOR 중 어느 것도 아닌 사람을 public auditor로, 나머지를 repo 팀으로 나누고 누가 어떤 일을 하는지 봤습니다.
| 분류 | 결함 스레드 | PR | Issue | 해결됨 |
|---|---|---|---|---|
| public auditor | 1,290 | 574 | 716 | 487 |
| repo 팀 | 583 | 440 | 143 | 462 |
전체로 보면 public auditor가 올린 결함 스레드는 repo 팀의 약 2.2배입니다. 그런데 종류별로 나눠 보면 격차가 한쪽으로 쏠립니다. “이거 깨졌다”는 신고에 해당하는 Issue는 716개 대 143개로 약 5배이고, 직접 고쳐서 올린 PR은 574개 대 440개로 약 1.3배입니다. 다시 말해 public auditor는 고치는 일보다 찾아내는 일에서 repo 팀을 훨씬 크게 앞섭니다. 신고되는 결함의 대부분은 프로젝트 바깥 사람들이 찾아냅니다.
반대로 마무리는 대부분 repo 팀이 합니다. 머지된 PR 비율이 더 높고, 자기 repo에 올라온 스레드를 더 많이 해결합니다. 그래야 맞습니다. 수정을 마무리하는 일은 commit 권한이 있고 맥락을 아는 프로젝트 내부에서 이루어져야 하니까요.
그러니 auditor와 메인테이너가 맞서는 구도가 아니라, 이미 잘 돌아가고 있는 분업입니다. 바깥 사람들이 점검 범위를 넓히고, 팀이 수정을 반영하고, 그렇게 한 바퀴 돌 때마다 벤치마크가 조금씩 나아집니다. 걸림돌은 이 일을 할 사람이 부족하다는 점이 아니라, 수정 하나를 둘러싼 모든 것이 흩어져 있다는 점입니다. 뒤에서 다루겠지만, 그 때문에 신고 한 건에 드는 품이 필요 이상으로 커집니다.
Top 10
| # | 이름 | 점수 | 결함 | PR | Issue | 연락처 |
|---|---|---|---|---|---|---|
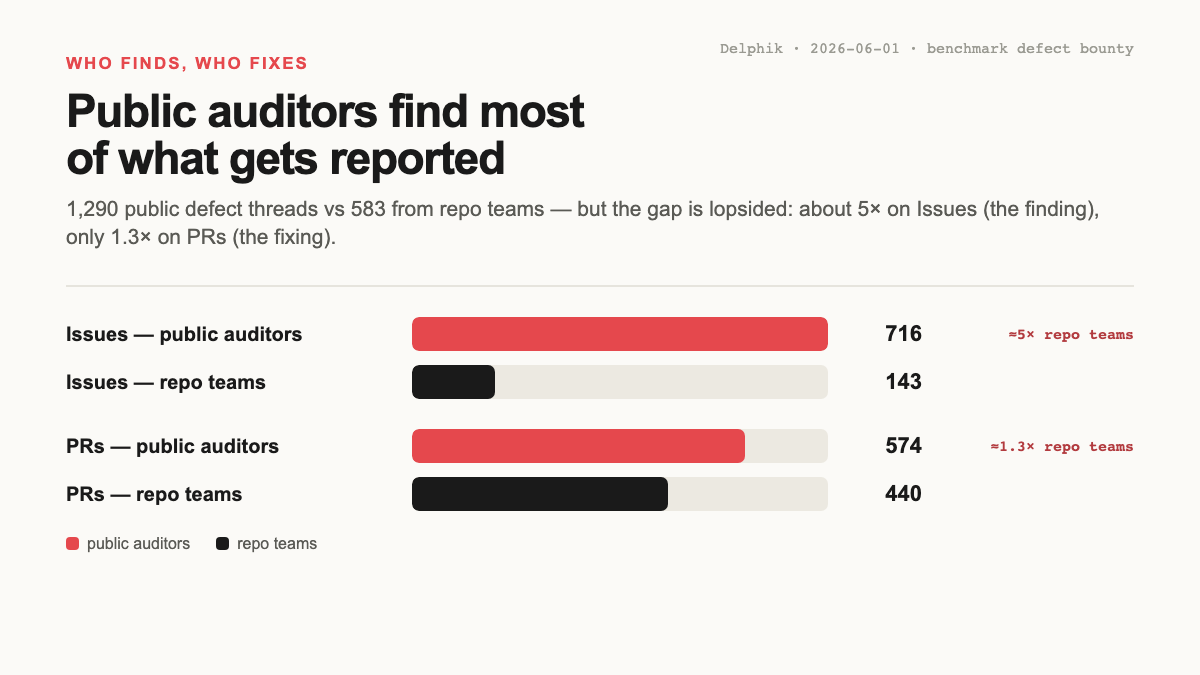
| 1 | Dariush Wahdany | 4,150 | 32 | 12 | 20 | @dwahdany |
| 2 | Chessing234 | 3,100 | 18 | 18 | 0 | GitHub |
| 3 | Kevin Xiang Li | 2,100 | 10 | 9 | 1 | @kevin_x_li |
| 4 | Ye | 2,050 | 18 | 15 | 3 | heye.me |
| 5 | Manojkumar Palanisamy | 1,950 | 16 | 4 | 12 | @smartmanoj42857 |
| 6 | Giulio Starace | 1,600 | 9 | 9 | 0 | @thelokasiffers |
| 7 | hzwer | 1,600 | 8 | 8 | 0 | @hzwer |
| 8 | Jason Poulos | 1,600 | 8 | 8 | 0 | poulos.ai |
| 9 | Simon Strandgaard | 1,600 | 8 | 8 | 0 | @SimonStran36407 |
| 10 | Zachary Blackwood | 1,600 | 8 | 8 | 0 | @blackaryz |
점수를 매길 때 PR은 Issue의 2배로 쳤습니다. PR은 문제를 알리는 데서 그치지 않고, 누군가 실제로 고쳐 보려 한 결과물이기 때문입니다. 여러 벤치마크에 걸쳐 활동하면 가산점이 조금 붙지만, 활동 범위가 넓다는 이유만으로 한 곳에 깊이 기여한 사람을 앞지르지 못하도록 상한을 뒀습니다. 머지 여부는 일부러 점수에 넣지 않았습니다. 조용한 repo에 올려서 머지되지 않은 PR도 누군가 들인 노력이기 때문입니다. 수정이 실제로 반영됐는지는 순위에 섞지 않고 따로 추적합니다. 전체 계산식은 글 끝에 있습니다.
명단에 오른 사람들이 활동한 곳은 지금 활발한 벤치마크들과 거의 겹칩니다. terminal-bench와 그 v2, SWE-bench 계열, ARC-AGI-2, ade-bench, frontier-evals입니다. 자기 분야에 꾸준히 등장하는 사람도 있고, 한 번 나타나 진짜 문제를 찾아 잘 정리해 올린 사람도 있습니다. 둘 다 이 명단에 오를 자격이 있습니다.
이제는 모델이 대신 해 주면 되지 않나요?
744명이 손으로 하고 있다고 하면 자연스럽게 나오는 질문입니다. 그래서 직접 실험했고, 결과는 다른 글에 따로 정리했습니다. 여기서는 이 글과 관련된 부분만 말씀드립니다. LLM auditor는 깨진 task 대부분에 문제가 있다는 것까지는 잡아냅니다. 하지만 가장 중요한 결함에서는 환경 전체를 줘도 원인을 잘못 짚는 경우가 더 많습니다. 여기서 말하는 결함은 프롬프트와 테스트가 서로 어긋나는 종류가 아니라, 시간이 지나며 달라지는 image나 유출된 정답처럼 인프라 쪽에 있는 결함입니다. 모델은 벤치마크를 탓하기 전에 자기 풀이부터 탓하는 경향이 있습니다.
핵심은 이렇습니다. 진단하기 가장 어려운 영역은 혼자 돌아가는 자동 감사 도구가 가장 약한 영역이고, 동시에 eval을 직접 돌린 사람이 가장 강한 영역입니다. task가 깨지는 바로 그 순간에 trajectory를 직접 보고 있었기 때문입니다. 이 명단의 744명은 자동화가 될 때까지 자리를 메우고 있는 사람들이 아닙니다. 자동화되지 않는 부분을 맡고 있는 사람들입니다.
왜 이 일에 필요 이상으로 품이 들까요?
힘든 것은 진단이 아니라 진단을 둘러싼 나머지 전부입니다. 벤치마크 결함 하나의 흔적은 결국 대여섯 군데에 흩어집니다. 결함이 처음 드러난 trajectory, 개인 메모, GitHub Issue, 뒤따르는 PR, 메인테이너의 답글, 그리고 운이 좋으면 수정이 실제로 들어간 릴리스까지입니다. 이 가운데 도구가 잘 갖춰진 것은 GitHub의 패치 과정뿐입니다. 이것들을 하나로 묶어 줄 벤치마크 고유의 맥락은 어디에도 한데 모이지 않습니다. 어떤 task, 어떤 버전, 어떤 실행에서 발견됐는지, 그리고 사람들이 실제로 돌리는 버전에까지 수정이 반영됐는지 같은 맥락입니다.
위에 소개한 분들이 그만큼 고생해야 했던 이유도 대부분 여기에 있습니다. 벤치마크 결함을 제대로 신고하는 일은 Issue 하나 쓰는 것으로 끝나지 않습니다. 내 에이전트가 아니라 task가 문제인지 확인하려고 eval을 다시 돌리고, trajectory를 남이 읽을 수 있게 줄이고, 여러 fork와 registry 사이에서 올바른 repo를 찾고, 담당 메인테이너를 찾고, 내용을 정리해 쓰고, 몇 주 뒤에 수정이 실제로 배포됐는지까지 확인하는 일입니다. 단계 하나하나는 작습니다. 하지만 합치면, 깨진 task를 만난 사람 대부분이 아무것도 올리지 않고 조용히 지나칠 만큼 번거로워집니다.
개인이 치르는 비용 말고도 문제가 하나 더 있습니다. 이 모든 것이 한 곳에서 추적되지 않다 보니 같은 일이 되풀이됩니다. 누군가 fork나 Discord에서 진단해 알린 결함이 다음 팀 눈에는 보이지 않고, 그 팀은 한 분기 뒤에 같은 결함을 다시 찾아내느라 연산 자원을 씁니다. 유지보수가 안 되고 있는 것이 아닙니다. 다만 한데 모이지 않아서, 업계 전체가 같은 수정에 값을 두 번 이상 치르고 있습니다.
Defect Hub의 역할
Defect Hub는 바로 이 빈틈을 메우려고 만든 것이고, 이 744명을 위한 것입니다. GitHub에 있는 것을 옮겨 오지는 않습니다. 머지와 논의는 메인테이너에게 그대로 맡깁니다. 대신 결함이 발견돼서 고쳐질 때까지, 벤치마크 고유의 맥락을 한데 묶어 둡니다. 에이전트가 결함을 만난 그 순간에 trajectory를 붙여 기록하고, task와 버전에 연결하고, 담당 메인테이너에게 전달하고, 수정이 실제로 배포될 때까지 추적합니다. 자세한 작동 방식은 출시 글에 있습니다. 목표는 두 가지입니다. 첫째, 결함 하나를 신고하는 데 드는 수고를 계속 줄이는 것입니다. 둘째, 한 번 검증되고 고쳐진 결함을 공개 기록으로 남겨서, 다음 팀이 같은 결함을 다시 찾느라 헤매지 않고 그냥 인용할 수 있게 하는 것입니다.
제품 이야기보다 이 글을 일부러 먼저 썼습니다. 우리가 돕고 싶은 일은 이미 일어나고 있고, 에이전틱 벤치마크가 버티고 있는 데에는 이 데이터셋의 744명이 큰 몫을 하고 있습니다. 이 명단에 계신 분들께 감사드립니다. 명단에 아는 분이 있다면 이 글을 전해 주세요.
방법
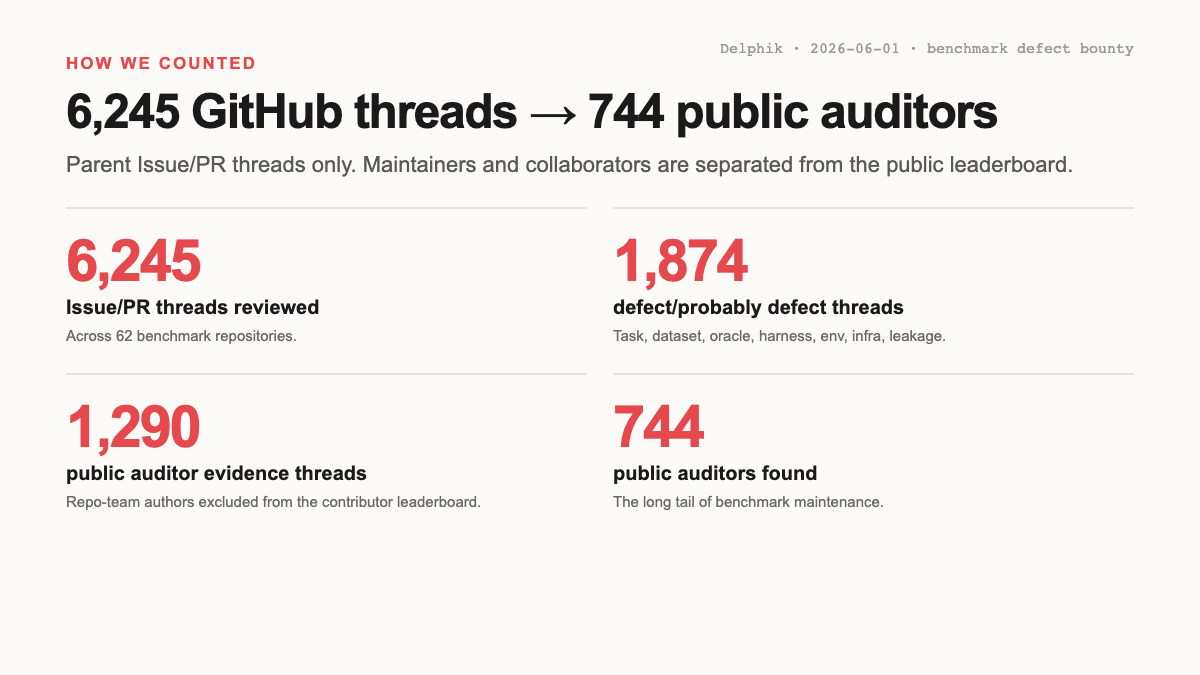
2026-06-01 스냅샷 기준으로, 에이전틱 벤치마크 repo 62개의 GitHub Issue/PR 스레드 6,245개를 검토했습니다.
- 스레드 1,874개를 결함 또는 결함 추정으로 분류했습니다.
- 그중 1,290개는 public auditor 744명이 작성했습니다(PR 574 / Issue 716).
- 583개는 repo 팀이 작성했습니다(PR 440 / Issue 143). 벤치마크 health 신호로는 남겨 두되, public auditor 리더보드에서는 제외했습니다.
점수 계산식:
evidence_score = 200 * defect_PR
               + 100 * defect_Issue
               + 100 * probably_defect_PR
               +  50 * probably_defect_Issue

leaderboard_score = evidence_score + repo_diversity_bonus

repo_diversity_bonus = +200 per extra benchmark repo, max +600
유의할 점:
- 집계 단위는 개별 댓글이 아니라 Issue나 PR 하나에 달린 스레드 전체입니다.
- Repo 팀은 GitHub author association(
OWNER,MEMBER,COLLABORATOR)으로 구분했고, bot도 리더보드에서 제외했습니다. - PR 점수는 머지 여부와 무관합니다. 머지된 PR은 수정이 마무리됐다는 뜻이지만, 머지되지 않은 PR도 누군가 고치려 했다는 근거입니다.
- 닫힌 스레드를 자동으로 fixed로 세지 않습니다. 머지 없이 닫힌 PR, 머지된 PR과 연결되지 않은 채 닫힌 Issue는 해결 여부가 확인되지 않은 묶음으로 따로 둡니다.
- 2026-06-01 시점에 GitHub에 공개된 내용만 조사한 결과입니다. 지금까지 있었던 모든 벤치마크 결함을 다 셌다는 주장이 아닙니다.
빠진 분이 있다면 알려 주세요. 744명이나 되는 명단이니 거의 틀림없이 있을 겁니다. 추가하겠습니다.